Imagine uma reunião de direção numa empresa industrial de média dimensão. O diretor-geral propõe começar a usar inteligência artificial com algo concreto: um assistente que responda aos clientes sobre prazos de entrega e condições comerciais. A diretora financeira lembra que o mesmo cliente aparece três vezes no ERP, com moradas diferentes. O diretor de operações acrescenta que a tabela de condições em vigor está no email de um comercial. Alguém sugere que primeiro é preciso "arrumar os dados", talvez com um data lake, e a decisão fica adiada para o ano seguinte.
A desconfiança está certa; a conclusão, quase sempre, está errada. A IA trabalha sobre os dados que lhe dão e, sobre dados desarrumados, erra sem dar sinal disso. Daí não se segue que a empresa tenha de arrumar tudo antes de começar, mas sim que tem de saber exatamente o que o primeiro caso precisa de ver arrumado, e arrumar isso bem.
A resposta curta: prontos para quê?
"Os nossos dados estão prontos para IA?" é uma pergunta sem resposta enquanto não se disser para que caso. Não há um nível geral de maturidade que dê luz verde a tudo. Há, para cada uso, poucas condições obrigatórias e muitas coisas que podem continuar como estão.
Os projetos de IA que vemos caem em três famílias: um assistente sobre documentos precisa de documentos atuais e com dono, uma previsão precisa de histórico consistente, uma automação que escreve no sistema precisa de dados mestre limpos. Estar pronto para a primeira e longe da terceira é perfeitamente normal.
Três tipos de caso, três exigências diferentes
O assistente que responde com base em documentos
É o caso mais pedido: um assistente interno que responde sobre procedimentos, condições comerciais ou fichas técnicas, citando a fonte. O problema raramente é o modelo de linguagem. É que, numa pasta partilhada típica, convivem a "Tabela_Condicoes_2023.pdf", a "Tabela_Condicoes_2024_FINAL.pdf" e a "Tabela_Condicoes_2024_FINAL_v2_revista.docx", e nada no sistema diz qual está em vigor. Quem é da casa ignora as duas primeiras; o assistente cita a de 2023 com uma clareza que convence.
Estar pronto, aqui, significa três coisas: cada documento usado tem uma versão em vigor identificável, cada família de documentos tem um dono que responde quando a informação muda, e está decidido quem vê o quê, porque um assistente que responde ao armazém não deve citar a grelha salarial guardada na mesma pasta. Não é preciso rever vinte anos de arquivo, basta garantir as cem ou duzentas fontes que respondem à maioria das perguntas.
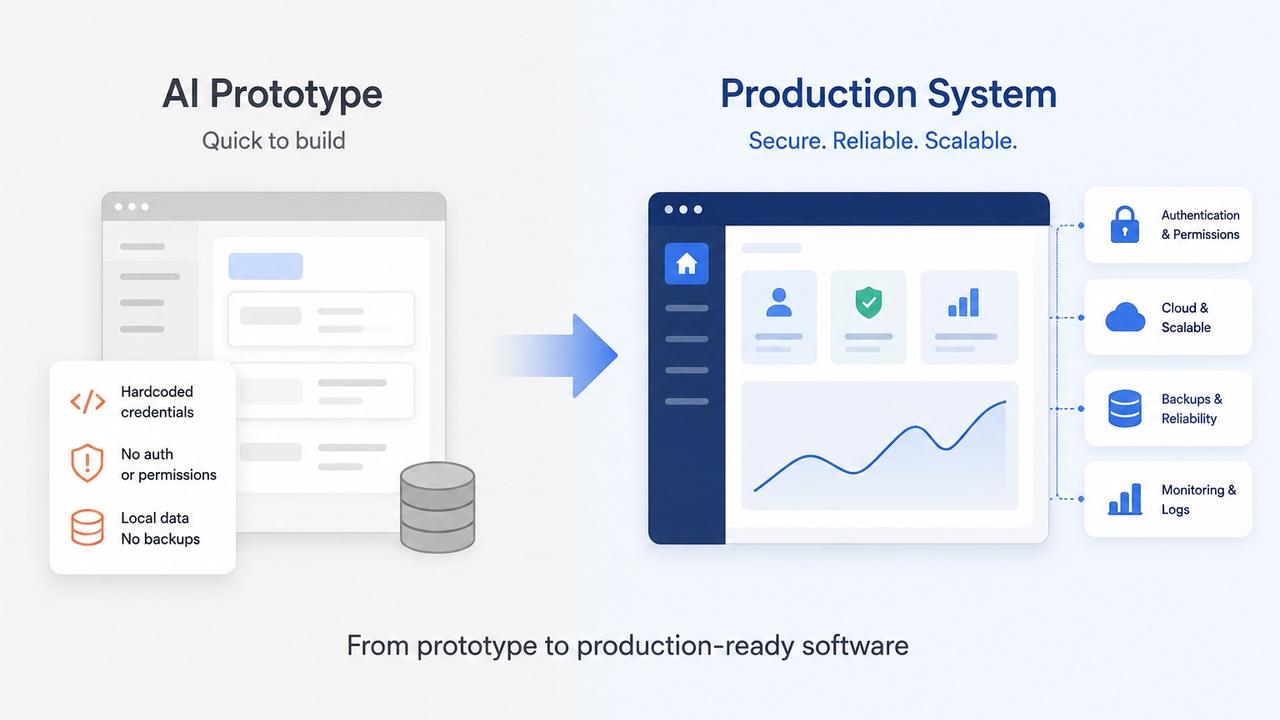
É também aqui que muitos protótipos enganam. Cada vez mais equipas montam um assistente no ChatGPT, no Claude ou no Gemini com meia dúzia de documentos escolhidos à mão, e funciona bem. Esse protótipo é útil: encurta o levantamento e baixa o preço do projeto. Mas não traz o que só aparece com as pastas reais, nem contas de acesso, ligação ao ERP, cópias de segurança e testes. É o que falta, em detalhe, no artigo sobre levar um protótipo feito com IA a produção.
A previsão: procura, cobranças, avarias
Prever vendas, atrasos de pagamento e tesouraria ou avarias exige histórico consistente: o mesmo artigo com o mesmo código ao longo do tempo, uma mudança de ERP que não reduziu o histórico anterior a saldos de abertura, e a capacidade de distinguir uma venda zero por falta de procura de uma venda zero por rutura de stock. Esta última é a armadilha clássica: um modelo que aprende com semanas de artigo esgotado conclui que ninguém o quer, e recomenda comprar menos precisamente daquilo que falta.
Como regra prática, uma previsão sazonal precisa de pelo menos dois ciclos completos, com promoções e devoluções assinaladas. Quando o histórico tem buracos, compensa muitas vezes começar por um dashboard de Business Intelligence que o consolida, e só depois pôr um modelo a prever.
A automação que escreve no sistema
O terceiro caso é o mais exigente e o de retorno mais fácil de medir: a IA lê uma encomenda que chegou por email, identifica cliente e artigos, e cria o documento no ERP para alguém validar. Aqui têm de estar limpos os dados mestre, as fichas de clientes, fornecedores e artigos sobre as quais assenta tudo o resto.
Os problemas repetem-se de empresa para empresa. Clientes duplicados, como "Silva & Filhos, Lda." e "Silva e Filhos Lda", com o mesmo NIF e condições de pagamento diferentes em cada ficha. Artigos com três códigos, o interno, o do fornecedor e o EAN que o cliente usa na encomenda, sem uma tabela que os ligue. NIF que não passam a validação do dígito de controlo, introduzidos à pressa há dez anos. Unidades que ora são caixa, ora unidade. Condições especiais escritas no campo de observações, onde nenhum sistema as lê com fiabilidade. Uma pessoa experiente contorna tudo isto sem pensar. Uma automação escolhe uma das fichas e segue em frente, e o erro só aparece na fatura.
A mecânica da leitura, com verificações cruzadas e fila de exceções, está no artigo sobre IA para processar faturas e encomendas. O que interessa aqui é o que tem de estar limpo antes, porque nenhuma verificação salva uma encomenda associada à ficha errada de um cliente que existe três vezes.
| Tipo de caso | O que tem de estar pronto | O que pode esperar |
|---|---|---|
| Assistente sobre documentos | Versão em vigor, dono, permissões | Arquivo antigo |
| Previsão | Códigos estáveis, ruturas e promoções assinaladas, dois ciclos | Dados de outras áreas |
| Automação no ERP | Fichas sem duplicados, códigos correspondidos, NIF válidos | Fichas inativas, campos não usados |
Sinais de que a casa está menos arrumada do que parece
- a mesma pergunta sobre um cliente dá respostas diferentes no ERP, no CRM e na folha de cálculo do comercial;
- existe uma folha de Excel "de correspondências" que só uma pessoa sabe atualizar;
- a resposta sobre o procedimento em vigor começa por "depende de quem lhe disser";
- os campos de observações têm mais informação útil do que os campos estruturados;
- ninguém sabe dizer quem decide qual de duas fichas duplicadas é a correta.
Nenhum destes sinais impede um projeto de IA. Indicam onde vai estar o trabalho.
Uma grelha de autoavaliação em oito perguntas
Não dá uma nota: mostra onde está a empresa e que primeiro caso é realista. Responde-se internamente numa semana, com consultas ao sistema e conversas com quem o usa.
- Quantos clientes ativos partilham o NIF com outra ficha? Se a resposta for "nenhum" ou "meia dúzia", uma automação sobre clientes é viável já. Se forem centenas, a deduplicação entra no âmbito do primeiro projeto.
- Os NIF passam a validação do dígito de controlo? É uma verificação simples. Uma percentagem visível de NIF inválidos mostra que a criação de fichas não tem regras, e que o problema volta se a origem não for corrigida.
- Cada artigo tem um código, ou existe uma tabela que liga os vários códigos? Sem ela, a leitura automática de encomendas e faturas começa por construí-la.
- Para os documentos que um assistente usaria, sabe qual é a versão em vigor e quem é o dono? Se sim, um assistente sobre documentos é dos casos mais rápidos de pôr em produção. Se não, o primeiro trabalho é organizacional, não técnico.
- Quantos anos de histórico tem no mesmo sistema, com os mesmos códigos? Com menos de dois ciclos completos, regras simples e um bom painel dão mais valor do que um modelo.
- As exceções estão em campos estruturados ou em observações livres? Se as condições especiais vivem em texto livre, a IA pode ajudar a extraí-las, uma vez, para campos próprios, o que já é útil por si só.
- Quem tem autoridade para decidir uma regra de dados? Se ninguém tem, o projeto fica à espera de decisões, e é isso, mais do que a técnica, que alarga prazos.
- Os dados estão acessíveis por uma ligação pronta do sistema, réplica da base de dados ou exportação automática, ou só pelo ecrã? Só pelo ecrã não impede o projeto, mas muda o esforço, como explicamos no artigo sobre integrar IA no software que a empresa já usa.
Se a maioria das respostas for clara, mesmo que não seja boa, a empresa está pronta para escolher um caso e começar. Se a resposta mais frequente for "não sei", o passo seguinte é um diagnóstico, não um projeto.
O mito do data lake antes de começar
A recomendação que mais adia projetos de IA é construir primeiro um data lake ou data warehouse que junte tudo, e só depois pensar em casos de uso. Parece prudente, mas tem três problemas.
Sem um caso concreto, ninguém consegue definir o que é "limpo": limpo para faturar não é limpo para prever, e quem limpa sem saber para quê uniformiza campos que ninguém vai usar e deixa por resolver os que importavam. Seis meses sem nada visível gastam a paciência da direção antes de haver retorno. E os dados continuam a degradar-se, porque a origem do problema, fichas criadas sem regras, nunca foi tocada.
A alternativa que funciona é começar por um caso, limpar o que esse caso precisa e corrigir a origem. Se o primeiro caso é ler encomendas por email, limpam-se os clientes e artigos que entram nelas, constrói-se a correspondência de códigos e passa a validar-se o NIF quando se cria uma ficha. O próprio caso torna-se o mecanismo de qualidade: cada encomenda que a automação não consegue associar com segurança vai para uma fila de exceções, e cada exceção resolvida corrige um registo. O trabalho de dados paga-se com as horas que o caso poupa e fica feito para o seguinte.
Uma camada central de dados faz sentido, mas como terceiro passo e não como primeiro: quando já há vários casos em produção a consumir os mesmos dados, ou quando a direção precisa de indicadores que cruzam sistemas. Aí, um Cérebro Digital ou uma plataforma analítica deixa de ser infraestrutura especulativa e passa a ter clientes internos à espera.
Duas respostas erradas
Pôr a IA a trabalhar sobre os dados como estão e esperar que ela perceba. Um modelo de linguagem ajuda a detetar fichas que são provavelmente o mesmo cliente. Não deve é decidir sozinho, em produção, qual usar: sobre dados mestre errados, a IA amplifica os erros a uma velocidade que nenhuma pessoa tem.
Fazer uma limpeza única e dar o assunto por arrumado. Sem regras na criação de fichas, uma deduplicação desfaz-se em meses. O que dura é mudar a entrada: validações, campos obrigatórios e um dono para cada tabela mestre.
Como fazemos
1. Diagnóstico gratuito e escolha do caso
Uma conversa sobre o processo que mais pesa e sobre a grelha acima, gratuita e sem compromisso. Sai-se com um caso concreto, com volume e horas estimadas.
2. Perfil dos dados que o caso usa
Uma a duas semanas a medir, com amostras reais, os dados de que o caso depende: duplicados, NIF inválidos, artigos sem correspondência, documentos em vigor. Separa-se o que se corrige automaticamente, o que pede revisão humana e o que pede uma decisão da empresa.
3. Limpeza dirigida e regras na origem
Propostas automáticas revistas por quem conhece clientes e artigos, nunca fusões cegas, e regras que impedem o problema de voltar. É também a ocasião para apagar dados pessoais que já não deviam estar guardados, em linha com o princípio de limitação da conservação do RGPD.
4. O caso em produção, com fila de exceções
O que o sistema não trata com segurança vai para uma pessoa. Essa fila é salvaguarda e indicador ao mesmo tempo: se diminui de semana para semana, os dados estão a melhorar.
5. Alargar sobre o que já está limpo
O segundo caso custa menos, porque herda dados limpos, acessos montados e regras validadas: o investimento em dados acumula-se em vez de se repetir.
Quanto custa o trabalho de dados
Na maior parte dos casos, o trabalho de dados faz parte do primeiro caso. Um primeiro caso de IA em produção situa-se entre 7.500€ e 15.000€, com prazo fechado no levantamento inicial, e inclui o perfil de dados e a limpeza dirigida quando o volume é razoável. Quando a limpeza é pesada, com milhares de fichas duplicadas ou histórico repartido por dois sistemas, o âmbito passa para o patamar de vários processos, entre 15.000€ e 25.000€.
Quando o caso é uma previsão e o histórico tem de ser consolidado primeiro, um dashboard de uma área, entre 10.000€ e 20.000€, é muitas vezes o ponto de partida certo, porque dá valor à direção antes de haver modelo. Uma base de conhecimento para vários departamentos, núcleo de um Cérebro Digital ou plataforma de IA da empresa, fica entre 25.000€ e 45.000€.
O valor sobe com o número de sistemas de origem, o acesso só pelo ecrã, documentos digitalizados sem texto e, sobretudo, decisões de negócio pendentes. Desce com um sistema principal, um dono interno com autoridade e um caso estreito. O custo mensal de operação está explicado no artigo sobre quanto custa implementar IA numa empresa em Portugal.
Quando não precisa de ninguém de fora
Por vezes não faz sentido contratar ninguém. Com algumas centenas de clientes e uma dúzia de duplicados, uma pessoa resolve isso em duas tardes no próprio ERP. Se os documentos já vivem organizados no SharePoint, com versões e permissões bem geridas, um assistente de mercado integrado no Microsoft 365 pode chegar, e é isso que lhe diremos.
Também não compensa avançar com uma previsão quando o histórico fiável não chega a dois ciclos completos: o modelo parece preciso nos testes e falha na primeira época diferente, e um painel com regras simples serve melhor a direção até lá. E não compensa limpar dados de um processo que vive todo em folhas paralelas: aí o problema é o sistema que não modela o negócio.
Perguntas para escolher o primeiro caso
- Que processo concreto quer melhorar primeiro, e quantas horas por semana consome hoje?
- Que dados esse processo usa, e em que sistemas ou pastas vivem?
- Quem, dentro da empresa, pode decidir regras de dados quando surgirem dúvidas?
- Que erro em produção teria custo real: uma fatura com condições erradas, uma resposta errada a um cliente?
- Que indicador mostraria, ao fim de três meses, que valeu a pena?
A forma mais rápida de saber se os dados estão prontos é olhar para eles com um caso na mão. É o que fazemos nos projetos de IA para empresas: escolher o primeiro caso, medir os dados que ele usa, arrumar o necessário e pô-lo em produção. Para perceber onde está a sua empresa, pode pedir um diagnóstico gratuito. Olhamos para o processo e para os dados, sem compromisso, e sai dessa conversa com um primeiro caso escolhido, ou com a indicação honesta de que ainda é cedo.